Limites de uso podem ser atingidos durante uma tarefa e obrigar o usuário a esperar, contratar outro plano ou trocar de serviço. Para reduzir o consumo de créditos e tokens, algumas práticas ajudam a organizar as interações com ferramentas de inteligência artificial.
O gasto depende do poder computacional exigido por cada comando. Prompts curtos e simples tendem a consumir menos do que tarefas extensas, que podem usar uma parcela significativa da franquia disponível.
Distribua as tarefas
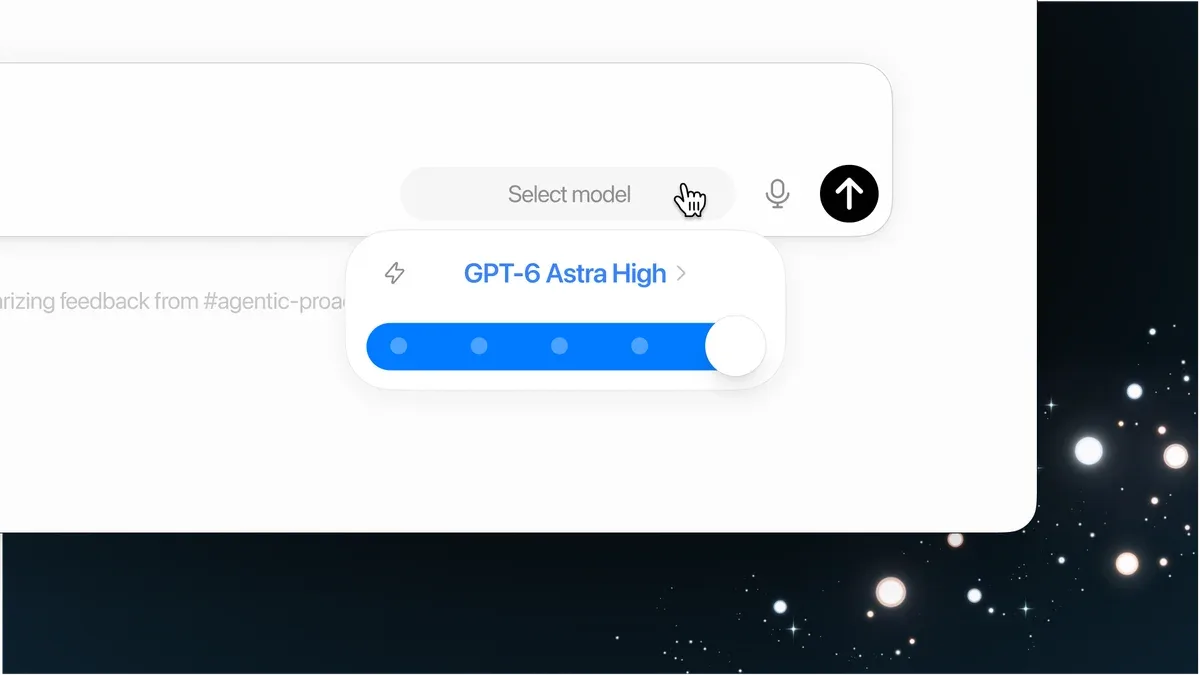
Uma opção é alternar entre serviços e modelos conforme a complexidade do pedido. Recursos mais avançados podem ficar para comandos difíceis, enquanto tarefas simples podem ser direcionadas a alternativas com menor impacto no limite de uso.
A versão gratuita do ChatGPT, por exemplo, não tem limites de uso para mensagens. Gemini, ChatGPT e Claude também oferecem telas para acompanhar os limites, embora o acesso possa depender do plano contratado. Esses painéis mostram o tempo restante para a restauração dos limites e quanto já foi consumido.
Reduza o volume processado
Arquivos mais leves ajudam a diminuir o consumo. PDFs podem ser convertidos para Markdown, enquanto planilhas formadas apenas por textos e números podem ser transformadas em CSV para facilitar a interpretação.
Também é recomendado reunir todas as solicitações no prompt inicial. Quando cada etapa é enviada em uma mensagem diferente, a ferramenta precisa interpretar novamente as informações anteriores. Um pedido pode incluir, de uma só vez, a consulta de celulares por custo-benefício, a comparação de especificações e a busca por ofertas.
Definir o tamanho da resposta é outra forma de controlar o uso. A inteligência artificial consome tokens tanto na entrada quanto na resposta, e indicar uma extensão específica evita que o texto seja prolongado sem necessidade. A recomendação consta no guia de uso dos modelos do ChatGPT elaborado pela OpenAI.
Organize as conversas
Quando o histórico não for necessário para a próxima resposta, iniciar uma nova conversa deixa as instruções mais limpas. Em um chat existente, a ferramenta analisa o conteúdo anterior a cada novo prompt, o que aumenta o consumo dos limites.
Por fim, regras já informadas não precisam ser repetidas. A OpenAI orienta que retirar instruções e exemplos repetidos e simplificar as descrições da ferramenta pode melhorar o desempenho e a eficiência de tokens.